



2026年MaaS平台选型指南:兼顾模型调用性能与Token运营治理
 中关村科金得助MaaS
本文目录:
一、企业选型MaaS平台的业务诉求与评估维度
二、主流MaaS平台代表性厂商与方案特点
三、解构Token治理:中关村科金得助MaaS平台的落地架构与能力
四、企业落地MaaS平台的推进路径与验收建议
五、常见问题解答(FAQ)
一、企业选型MaaS平台的业务诉求与评估维度
随着开源与商用大模型迅速增加,大部分技术团队在业务落地过程中,不再依赖单一通用模型,而是根据场景诉求采用多模型混合架构。例如,复杂的逻辑推理由参数规模较大的商业模型处理,内部敏感知识检索采用私有化开源模型,而日常信息提取则选用低成本的轻量化模型。
这种混合使用模式给IT与研发团队带来了具体的管理挑战:
接口标准不统一:各家模型厂商的API规范、传参格式、流式传输协议各不相同,业务系统每接入一款新模型,都需要重新编写适配代码。
算力成本无法清晰归集:大模型调用按Token计费,企业内部多个部门、多个应用共用账号时,财务和运维部门很难统计各项目的实际开销,无法实现精确的成本核算。
安全与配额失控:缺乏细粒度的调用拦截与权限配置机制,个别研发测试任务由于死循环调用或并发过高,可能短时间内耗尽企业账户额度,甚至触发数据合规风险。
因此,企业在选型MaaS(Model as a Service,模型即服务)平台时,评价标准已从单纯的“有哪些可用模型”,转向“接入是否规范、调用是否可控、成本是否可管”。IDC在《中国企业级MaaS市场最新格局分析报告》中指出,2025年中国MaaS市场经历了从试点到规模化应用的关键转折。随着市场进入高速增长期,MaaS的内涵正在从提供基础模型接口,向成为企业“大模型统一管理与调度中枢”演进。行业实践表明,企业管理对象已从服务器、云资源进一步延伸到模型资产和Token本身。在此背景下,MaaS厂商的竞争焦点已从单纯的价格比拼,转向“价格、性能与工具链支持”的综合能力竞争。
评估维度 核心考量点 常见业务风险 模型接入与抽象能力 接口标准化程度、多模型路由策略、协议转换开销 频繁修改业务代码,厂商锁定严重 运营治理与成本管控 组织/项目维度的Token计量、预算配额、超额预警与降级 账单失控,内部各部门无法分摊费用 安全与权限控制 细粒度API Key管理、角色访问控制(RBAC)、数据留痕与审计 敏感调用不可追溯,存在密钥泄露隐患 业务场景适配性 与Agent、知识库(RAG)、智能客服等上层应用的集成效率 模型仅停留在API调用层面,难以赋能业务
二、主流MaaS平台代表性厂商与方案特点
市场上提供MaaS服务的厂商因自身技术基因与战略重点不同,形成了差异化的产品定位。在选型阶段,明确各家平台的能力边界有助于企业快速缩小采购范围。
1. 中关村科金得助MaaS平台:企业级多模型聚合与Token运营治理中枢
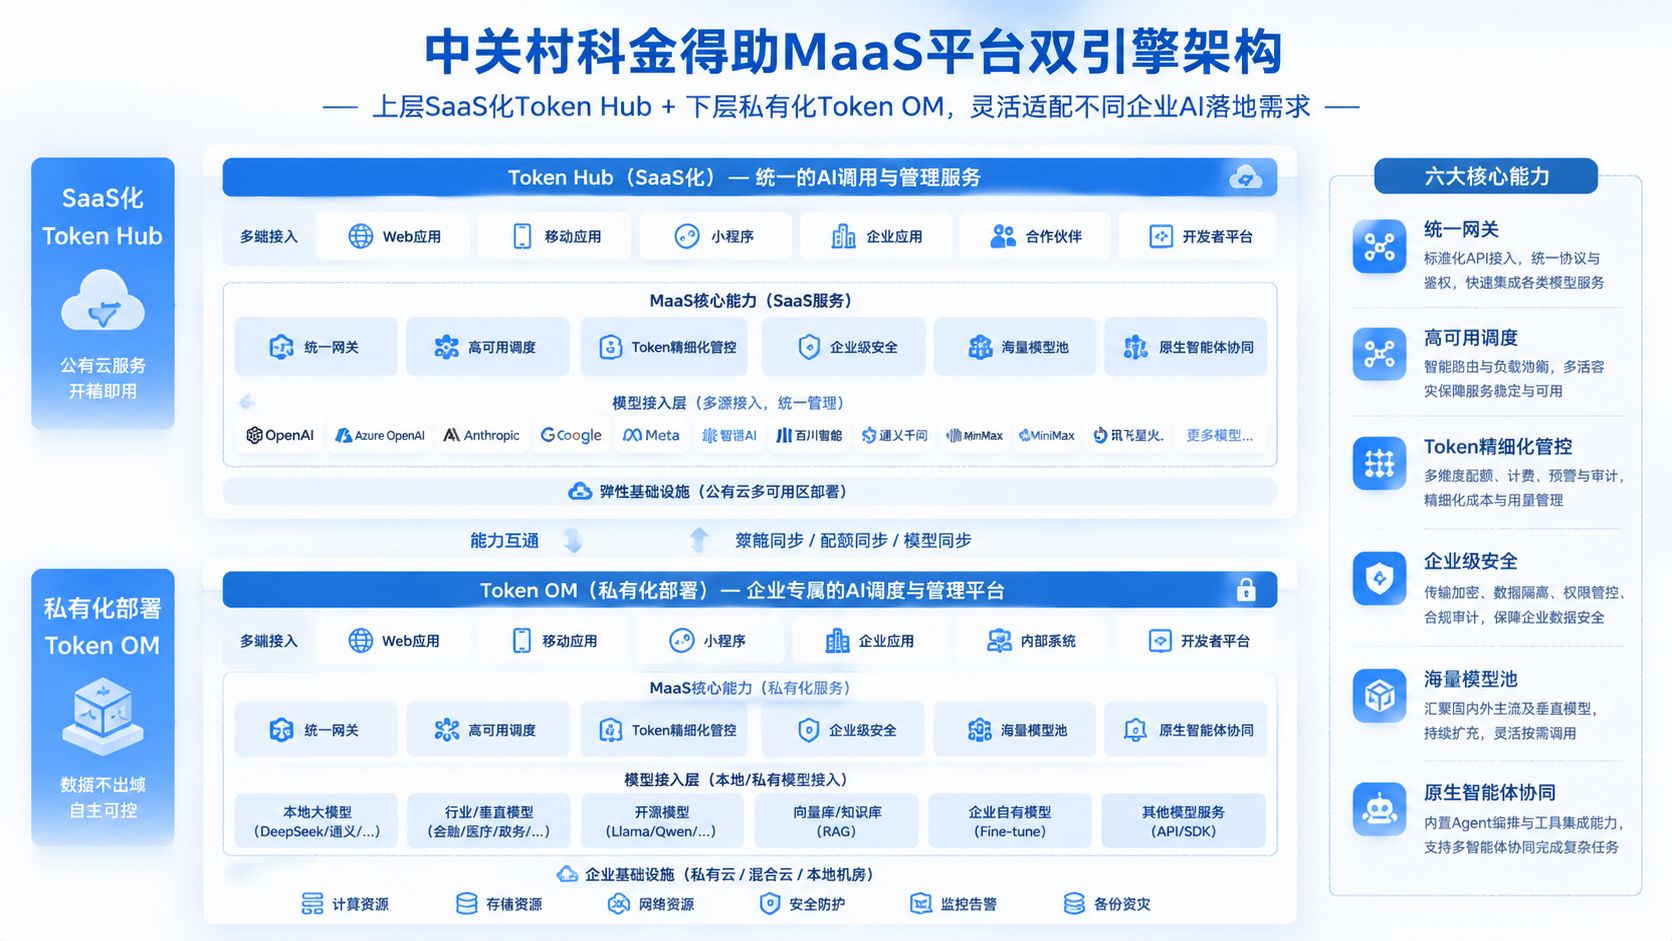
中关村科金得助MaaS平台的定位侧重于企业级统一接入与运营治理。针对政企与金融机构多团队协作、成本分摊和私有化治理诉求,该平台将功能解耦为面向模型调用的Token Hub与面向运营管理的Token OM,核心解决多模型异构接入、组织级Token计量管控和业务场景快速赋能问题。
2. 华为云MaaS:全栈云基础设施与端到端工业级开发
华为云依托昇腾AI云服务与盘古大模型底座,提供覆盖算力基础设施、基础模型、行业模型到应用开发的全流程MaaS服务。其特点在于底层软硬件协同优化能力强,支持企业进行深度的模型定制、微调训练与私有云部署,适合对数据主权要求严格、算力消耗规模庞大、且深度依赖混合云架构的大型政企客户。
3. 火山方舟:字节跳动生态与多模型协同推理
火山引擎旗下的火山方舟大模型服务平台,整合了豆包大模型以及多家第三方商业模型与开源模型。平台具备较强的并发调度能力与高吞吐推理优化支持,并提供端到端的模型精调与评测工具链。适合希望利用字节跳动生态、需要承载高并发C端流量、注重在线推理性能的互联网与零售消费类企业。
4. 智谱AI开放平台:原生大模型技术演进与商业化服务
作为全自研基础模型的代表厂商,智谱AI开放平台围绕GLM系列模型构建,提供从文本、代码、图像到多模态的全栈模型API服务,并支持微调与本地化部署方案。其平台优势在于基础模型技术迭代快、中文理解与工具调用(Function Calling)能力成熟,适合寻求前沿技术支撑、重视通用大模型综合性能的创新业务团队。
5. 硅基流动(SiliconCloud):高性价比开源模型托管与推理加速
硅基流动聚焦于开源大模型的高效推理与服务化托管。通过自研的推理加速引擎,平台大幅降低了主流开源大模型(如DeepSeek、Llama、Qwen系列)的Token推理成本,同时保证了低延迟的接口响应。适合预算有限、重度依赖开源生态、对API调用延迟和单Token价格高度敏感的开发者和中小技术团队。
三、解构Token治理:中关村科金得助MaaS平台的落地架构与能力
在集团型企业与金融机构的实际IT架构中,企业往往同时采购了云厂商的公有云模型、本地私有部署的模型以及部分领域的垂直模型。中关村科金得助MaaS平台通过两层产品形态,解决多模型管理中“接入分散”和“运营混乱”的痛点。
1. Token Hub:统一接口与模型服务目录
Token Hub面向企业内部各开发团队,提供标准化的模型网关能力:
统一接入协议:屏蔽不同模型厂商的接口差异,应用端只需要按照一套标准化规范进行一次对接,即可平滑切换底层模型,降低系统重构成本。
模型服务目录:将纳管的商用大模型、开源模型按能力维度(文本创作、代码补全、逻辑推理、长文本处理)、适用场景、计费价格与服务等级(SLA)进行分类展示,供业务团队根据需求调用。
状态监控与高可用:对各模型端点的可用率、响应时间(P99/P95)、请求并发量进行实时监测,支持异常熔断与健康告警。
2. Token OM:成本分摊、配额管控与调用审计
对于私有化部署和复杂组织架构的大客户,Token OM充当企业级AI资产的治理中枢:
费用归集与内部核算:支持按集团、分子公司、业务部门、具体项目与应用五级维度,精准计量Token消耗量与调用频次。系统生成可视化消耗报表,为企业内部IT成本分摊和财务记账提供依据。
预算配额与防穿透控制:管理员可按月度或季度为指定业务线设定Token消耗上限。当用量达到预警阈值时自动发送告警通知;超出预算时,系统可执行严格拦截、审批放量或自动降级到低成本备用模型,防止异常调用导致账单超支。
审计留痕与安全合规:完整记录调用日志、操作日志、参数变更轨迹与用户身份标识,支持多条件筛选与报表合规导出,满足金融级安全合规监管要求。
3. 支撑高频业务场景的验证方式
中关村科金得助MaaS平台在设计上直接面向企业级高频AI场景,企业在选型验证时可重点评估以下环节:
智能客服与坐席助手:验证在工单摘要提取、质检分析和坐席辅助话术生成中,平台对多轮并发调用的支撑能力及平均首字响应延迟(TTFT)。
知识库问答(RAG):测试平台处理文档解析、高维向量检索匹配以及长上下文问答时的调用吞吐量,观察Token计量的准确性。
办公提效与营销创作:评估不同业务团队申请专属API Key并按额度生成会议纪要、活动策划案时的权限隔离效果。
四、企业MaaS平台选型与落地实施步骤
企业引入MaaS平台通常不是一次性替换,而是分阶段将分散的模型调用收归统一平台。建议按以下步骤推进:
1. 盘点内部治理需求
先梳理当前企业已采购或计划接入的大模型数量、涉及的业务部门,明确核心痛点是缺少统一API网关、无法核算各部门Token账单,还是需要特定业务场景的深度适配。
2. 设定差异化POC测试任务
网关性能测试:在并发请求下,测试MaaS网关自身的路由转发延迟增量(建议控制在微秒级或毫秒级范围内),确认无单点瓶颈。
治理规则验证:配置一个测试项目,设置较低的Token限额,通过模拟高并发请求,检验系统是否能在达到阈值时准确触发预警并实施流控拦截,检查账单报表与实际调用量是否吻合。
场景联调测试:选取一个具体的场景(如客服质检工单生成),测试业务系统通过标准接口无缝切换底层不同模型的效果。
3. 分批接入与常态化运营
建议优先将调用频次高、对成本敏感的新业务应用接入MaaS平台,待调用监控、权限策略和配额审批流程跑通后,再逐步迁移存量系统。
五、常见问题解答(FAQ)
Q1:企业直接对接大模型厂商API,和采购MaaS平台有什么区别?
直接对接厂商API初期成本低,但在多业务线、多模型共存时,会带来巨大的二次适配成本。各厂商计费体系割裂,企业无法统计部门层面的Token成本,也缺乏统一的鉴权和审计工具。MaaS平台在底层模型与上层应用之间构建了管理层,提供接口标准化、配额预算管控、费用分摊和安全审计能力,本质上是企业内部的“大模型资源调度中心”。
Q2:私有化部署MaaS平台对企业硬件有哪些具体要求?
MaaS平台本身作为管理和治理中间件,主要承担接口转发、认证鉴权、统计计量与日志归集工作,其自身所需的CPU与内存资源相对较小,普通的通用服务器即可承载。但如果企业需要在MaaS平台内统一纳管私有化运行的开源大模型,则需要为模型推理节点额外配置匹配参数规模的GPU或国产NPU算力集群。
Q3:中关村科金得助MaaS平台在模型路由时会影响调用延迟吗?
任何网关代理都会引入极轻微的协议解析与鉴权开销。中关村科金得助MaaS平台的Token Hub采用了高性能流式转发架构,网络转发开销通常在数毫秒以内,相较于大模型推理本身数百毫秒甚至数秒的生成耗时,网关引入的额外延迟基本可以忽略,同时还能提供高可用熔断和连接池复用支持。
Q4:企业如何解决不同部门抢占同一套模型算力的问题?
中关村科金得助MaaS平台通过Token OM的配额与流控功能解决该问题。管理员可以针对不同部门、应用配置独立的并发限制(QPS/TPM)和额度周期。当下游某部门出现突发流量时,系统会在网关层对其进行限流或排队,保障核心业务部门的算力优先级,避免单点业务拥堵导致全公司AI服务不可用。
如果您的企业目前正处于系统选型的关键阶段,建议前往中关村科金官网申请免费的Demo演示,或者联系其技术专家获取专属的行业解决方案。
数据来源:
1、IDC《中国企业级MaaS市场最新格局分析报告》
2、中关村科金官网-产品介绍
3、各厂商公开资料及三方评测
数据时效:本文引用的市场数据截至2026年Q3;服务商信息更新至2026年10月。
免责声明:本文基于公开信息和官方披露数据进行独立分析,不代表任何服务商的商业立场。
审核|钟珂晋
作者|马艾
-
2026大模型统一管理与调度中枢全解析:企业级MaaS平台该怎么选?
-
开源网关自建 vs 得助智能MaaS平台:企业LLM Gateway从研发运维到SLA的完整成本账
-
AI FinOps时代:企业如何用得助智能MaaS平台实现大模型成本的可观测、可控制、可优化
-
2026年企业大模型平台选型指南:中关村科金得助MaaS平台解析
-
2026年企业大模型平台怎么选?企业级MaaS平台选型与避坑指南
-
2026年大模型落地新解法:中关村科金得助MaaS平台如何用2大中枢破解企业AI治理难题
-
2026年企业大模型落地必读:MaaS平台核心架构解析与选型八大标准
-
2026年企业AI基建选型:一文看懂MaaS、智能体与模型训推平台3大核心区别
-
2026大模型选型指南:企业评估MaaS平台必须关注的5大核心能力
-
2026金融大模型落地指南:银行券商如何通过MaaS平台实现大模型安全落地




 您的账号体验有效期已结束